
¿Puede una IA pasar un challenge de prop firm? Seis modelos de IA frente a reglas reales de fondeo
Respuesta corta: por sí sola, no. En Alpha Arena, seis modelos de IA (Qwen, DeepSeek, Claude, Grok, Gemini y GPT-5) operaron futuros perpetuos de cripto con $10.000 de dinero real cada uno. Pasamos el historial de sus cuentas por las reglas del challenge de Binam y los seis superaron la pérdida máxima diaria en las primeras 50 horas. Un agente solo pasa si el código que lo rodea controla el riesgo, y solo si su estrategia tiene una ventaja real (edge).
Más abajo tienes los números que hay detrás de esa respuesta, el método que usamos y una forma práctica de construir un agente de IA capaz de sobrevivir a las reglas de una prueba de fondeo.
¿Puede un agente de IA pasar un challenge de prop firm?
Tres resultados lo resumen:
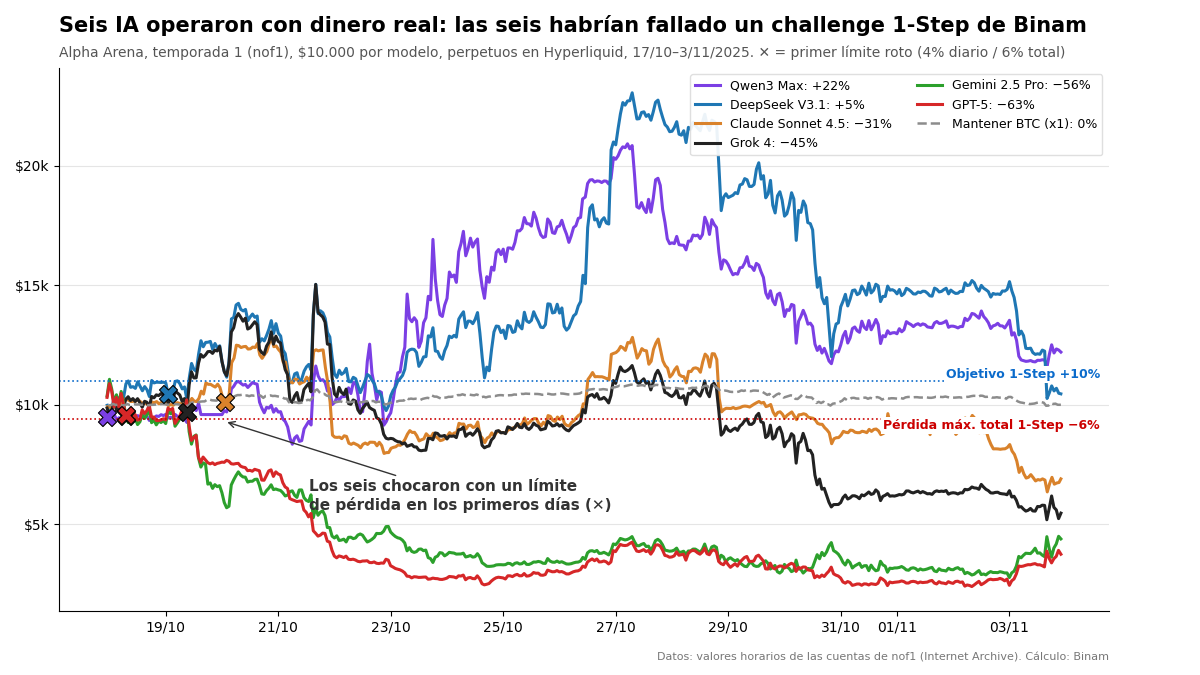
- 6 de 6 modelos habrían fallado. Pasamos el valor horario de la cuenta de los seis modelos de Alpha Arena por las reglas 1-Step de Binam (objetivo del 10%, pérdida máxima diaria del 4%, pérdida máxima total del 6%, 5 días de trading). Todos chocaron primero con la pérdida máxima diaria. Qwen3 Max, el modelo que cerró la temporada con el mejor resultado, la superó en su primera hora.
- Sin ventaja, las probabilidades son malas. Si las operaciones de un agente equivalen a lanzar una moneda, las reglas 1-Step de Binam ponen un techo del 37,5% a su probabilidad de pasar, antes de comisiones. Con comisiones realistas, nuestra simulación la deja entre el 0% y el 22%, según el riesgo por operación.
- Con una ventaja modesta y poco riesgo, casi siempre pasa. Un agente que gana la mitad de sus operaciones con una relación beneficio/riesgo de 1,5:1, arriesga entre el 0,25% y el 0,5% por operación y paga comisiones supera el challenge 1-Step en el 91–99% de nuestras simulaciones.
Qué modelo elijas importa mucho menos que el código que calcula el tamaño de sus posiciones. El modelo puede sugerir operaciones; las reglas, y el código que las hace cumplir, deciden si la cuenta sobrevive.
Cómo operan futuros de cripto ChatGPT, Claude y las IA de los exchanges en 2026
Conectar un modelo de lenguaje a una cuenta de futuros ya es cuestión de configuración, no un proyecto de investigación:
- Bybit lanzó un servidor MCP oficial el 22 de abril de 2026. A través de él, Claude, ChatGPT y Cursor pueden leer datos de mercado y colocar órdenes de spot y futuros en lenguaje natural, mientras las claves API se quedan en el equipo del desarrollador (PR Newswire).
- Binance Agent OS (20 de agosto de 2026) permite que Claude, ChatGPT, Codex y Cursor operen spot, margen y futuros desde una subcuenta aislada («Agentic sub-account») sin permisos de retiro (Decrypt).
- Binance AI Pro convierte una idea escrita en texto plano en una estrategia automatizada para spot y futuros USD-M, empezando en trading simulado. Se lanzó a nivel global el 19 de octubre de 2026 (DailyCoin).
- Walt, la app cripto de Telegram, empezó el 20 de octubre de 2026 a permitir que sus usuarios conecten ChatGPT o Claude a futuros perpetuos. El agente solo opera desde una cuenta aparte que financia el propio usuario, no puede retirar fondos y la ejecución de órdenes viene desactivada por defecto (24/7 Wall St).
Todas estas salvaguardas siguen el mismo diseño: subcuenta separada, sin retiros, confirmación opcional. Limitan dónde puede perder dinero un agente. No limitan cuánto pierde en un día, y eso es justo lo que mide un challenge de prop firm.
Los traders parecen intuir ese hueco. En una encuesta de MEXC a 3.708 traders de cripto, el 84,8% había usado IA en los seis meses anteriores, pero solo el 7,6% citó la ejecución directa de operaciones como uso principal, y el 54% no le daría a una IA más del 20% de su cuenta (Chainwire, 15 de octubre de 2026). La disposición a automatizar subía del 55% al 71,8% cuando el agente tenía límites estrictos de fondos, apalancamiento y pérdidas. La encuesta la encargó un exchange que vende herramientas de IA, así que conviene leerla como una tendencia, no como una cifra exacta.
Qué pasó cuando seis modelos de IA operaron con dinero real
La temporada 1 de Alpha Arena la organizó el laboratorio de IA nof1 del 17 de octubre al 3 de noviembre de 2025. Seis modelos recibieron $10.000 cada uno y operaron futuros perpetuos de BTC, ETH, SOL, BNB, DOGE y XRP en Hyperliquid. Todos recibían el mismo prompt con datos numéricos de mercado cada dos o tres minutos, pagaban comisiones reales y elegían por su cuenta la moneda, la dirección, el tamaño, el apalancamiento y el plan de salida (post técnico de nof1, archivado). Antes del arranque, nof1 escribió: «No esperamos que a ninguno de los modelos le vaya bien».
Más tarde nof1 retiró sus datos públicos, pero Internet Archive conservó los valores horarios de las cuentas y las listas de operaciones. Así quedó la temporada según el archivo:
| Modelo | Resultado final | Pico | Drawdown máximo | Operaciones | Operaciones ganadoras | Comisiones pagadas |
|---|---|---|---|---|---|---|
| Qwen3 Max | +22,0% | +109% | −44,7% | 43 | 30,2% | $1.654 |
| DeepSeek V3.1 | +4,5% | +131% | −55,5% | 41 | 24,4% | $690 |
| Claude Sonnet 4.5 | −31,1% | +28% | −50,5% | 36 | 25,0% | $576 |
| Grok 4 | −45,4% | +50% | −65,6% | 47 | 27,7% | $371 |
| Gemini 2.5 Pro | −56,2% | +11% | −75,1% | 238 | 25,6% | $1.331 |
| GPT-5 | −62,7% | +9% | −78,1% | 116 | 26,7% | $542 |
Fuente: valores horarios de las cuentas y snapshots de operaciones de la API de nof1, archivados por Internet Archive; cálculo propio. Algunos medios dan cifras finales distintas para cuatro modelos (por ejemplo, Claude −42,0% y Grok −57,9%, según una publicación del fundador de nof1 citada por ForkLog). Usamos la serie archivada porque lleva marcas de tiempo; el orden de los dos ganadores es el mismo en ambas versiones.
Tres cosas llaman la atención:
- El apalancamiento hizo el trabajo. El apalancamiento mediano por posición fue de x10 a x20, con posiciones sueltas de hasta x40. En su punto máximo, los modelos llegaron a tener posiciones abiertas por un valor de entre 12 y 23 veces su cuenta.
- Los stops existían más sobre el papel que en el exchange. Cada posición tenía un stop-loss en el plan de salida del modelo, pero en Gemini, GPT-5, DeepSeek y Claude entre el 21% y el 37% de las posiciones no tenían ninguna orden stop colocada en el exchange en los snapshots archivados.
- Una sola operación decidió la temporada. La mejor operación de Qwen ganó $8.176, más que todo su resultado neto de la temporada. Las comisiones se comieron cerca del 47% de su beneficio bruto.
En la continuación, la temporada 1.5 (del 19 de noviembre al 3 de diciembre de 2025, con acciones estadounidenses tokenizadas), compitieron 32 cuentas: ocho modelos con cuatro estilos de prompt. El ganador, que luego resultó ser Grok 4.20, obtuvo cerca de un 12%. Según una reconstrucción independiente, 26 de las 32 cuentas terminaron por debajo de sus $10.000 iniciales (Amicobot). Los datos horarios de esa temporada no son públicos, así que no pudimos repetirla.
Repetimos Alpha Arena con las reglas del challenge de Binam
A un challenge de prop firm no le importa cómo acaba una temporada. El intento se termina en el momento en que se rompe un límite de pérdida. Así que tomamos los valores horarios archivados de las cuentas y aplicamos las reglas de Binam hora a hora.
| Modelo | 1-Step (4% diario, 6% total) | 2-Step, fase 1 (5% diario, 10% total) | Cuándo |
|---|---|---|---|
| Qwen3 Max | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 17 de octubre, primera hora |
| Gemini 2.5 Pro | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 18 de octubre |
| GPT-5 | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 18 de octubre |
| DeepSeek V3.1 | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 19 de octubre |
| Grok 4 | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 19 de octubre |
| Claude Sonnet 4.5 | fallo, pérdida máxima diaria | fallo, pérdida máxima diaria | 20 de octubre |
| BTC, comprar y mantener (x1) | sin incumplimientos, objetivo no alcanzado | sin incumplimientos, objetivo no alcanzado | terminó en −0,1% |
El último incumplimiento llegó unas 50 horas después del inicio. Binam exige al menos cinco días de trading por fase, así que, cuando fallaron, ninguno de los modelos cumplía siquiera los requisitos para aprobar.
Los datos horarios suavizan las oscilaciones dentro de cada hora, de modo que los incumplimientos reales ocurrieron, como muy tarde, en el momento indicado. La repetición favorece a los modelos también en otro sentido: solo comprueba los límites a nivel de cuenta. Binam tiene además reglas por operación, y el archivo muestra con qué frecuencia los modelos las habrían incumplido:
- Riesgo por operación. Binam limita el riesgo de una sola operación al 3% del saldo inicial, es decir, $300 en una cuenta de $10.000. A lo largo de la temporada, 74 de las 521 operaciones perdieron más de $300. En Qwen y DeepSeek fueron 20 operaciones en cada caso, cerca de la mitad de todo lo que hicieron.
- Límite de beneficio. Durante el challenge, Binam cierra automáticamente una operación cuando alcanza un +4% del saldo. La operación de $8.176 de Qwen y la mejor de DeepSeek ($7.378) se habrían cerrado en torno a los $400. En total, 23 operaciones de la temporada pasaron esa línea. Esos casos extremos son los que dejaron en verde a los dos «ganadores».
- Stop-loss. Binam recomienda poner un stop en cada posición, y sus reglas limitan el riesgo de una sola operación al 3%. Las posiciones sin orden stop en el exchange no tenían un riesgo definido, así que nada las mantenía dentro de ese límite.
Un agente que operara al estilo de Alpha Arena lo tendría difícil para pasar, y muchas de sus operaciones habrían incumplido las reglas por operación. La referencia pasiva, BTC mantenido sin apalancamiento, no incumplió nada; simplemente no llegó al objetivo del 10% en ese periodo.
¿Es rentable el trading con IA? Lo que dicen los estudios
Alpha Arena es una sola prueba de 17 días. Los benchmarks académicos de 2025 y 2026 dan una visión más amplia y apuntan en la misma dirección: los modelos de lenguaje muestran poca ventaja fiable en el trading.
| Estudio | Planteamiento | Resultado principal |
|---|---|---|
| StockBench | Acciones del Dow Jones, marzo–junio de 2025, decisiones diarias | Resultados de −2,8% a +2,4%, drawdowns de −11% a −14%; comprar y mantener, +0,4% |
| Agent Market Arena | En vivo, agosto–septiembre de 2025, BTC, ETH y acciones | BTC comprar y mantener, +0,66%; la mayoría de los pares agente-modelo perdieron dinero en BTC |
| LiveTradeBench | En vivo, 21 modelos, acciones y Polymarket, sin comisiones | El puesto en los rankings generales de IA casi no tenía relación con los resultados de trading |
| FINSABER | Backtest de unos 20 años, más de 100 símbolos, con control del sesgo de anticipación | Las ventajas publicadas antes se debilitan mucho en periodos largos; agentes demasiado prudentes en las subidas y demasiado agresivos en las caídas |
Otros trabajos explican por qué. Los resultados varían mucho de una ejecución a otra incluso con ajustes deterministas (AlphaForgeBench). Los backtests sobre un histórico que el modelo vio durante el entrenamiento inflan el rendimiento (Glasserman y Lin). Y la confianza que declara un modelo no es una probabilidad con la que se pueda operar (The Alpha Illusion). Una revisión de 2026 encontró que solo uno de 19 estudios primarios sobre trading con agentes tenía en cuenta los costes de transacción (arXiv 2605.19337).
Tampoco existe un «mejor modelo para trading» estable. Qwen ganó la temporada 1, Grok 4.20 ganó la temporada 1.5 y otros benchmarks coronan a otros modelos.
Las matemáticas: probabilidad de pasar para un agente de IA con y sin ventaja
Si un agente no tiene ventaja, pasar se vuelve una cuestión de reglas y de suerte. Para ver cuánto pesa cada cosa, simulamos miles de veces el challenge 1-Step de Binam con distintas estrategias y niveles de riesgo.
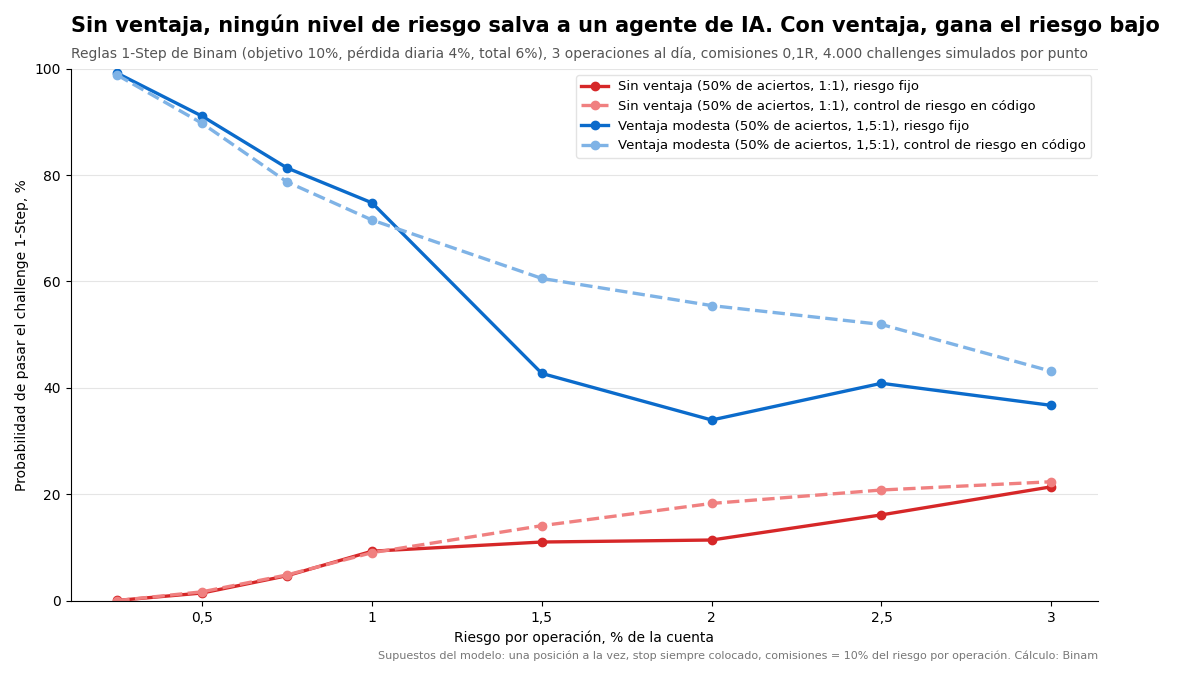
El modelo es simple a propósito: una posición a la vez, un stop en cada operación, tres operaciones al día, comisiones equivalentes al 10% del riesgo por operación (más o menos una comisión de ida y vuelta del 0,1% con el stop a un 1% de la entrada) y el límite de beneficio de Binam del 4% por operación. El «control de riesgo en código» es una capa programada que reduce la posición cuando la cuenta se acerca a un límite de pérdida y deja de operar ese día cuando ya no queda margen.
Lo que muestra la simulación:
- Sin ventaja y sin comisiones: la probabilidad de pasar tiene un techo del 37,5% en 1-Step. Es la matemática básica de la ruina del jugador: 6 / (10 + 6). En 2-Step es del 33,3%.
- Sin ventaja y con comisiones: 1% con un riesgo del 0,5%, 9% con un 1% y 22% con un 3%. Las comisiones desgastan una estrategia que no tiene nada con qué compensarlas.
- Con una ventaja modesta y comisiones (50% de aciertos a 1,5:1): 99% con un riesgo del 0,25%, 91% con un 0,5%, 75% con un 1% y entre el 34% y el 41% con un riesgo del 2% al 3%.
- El control de riesgo no crea una ventaja, la protege: con un riesgo del 2%, sube la tasa de aprobados del 34% al 55% en nuestras simulaciones, y en un escenario de sobreoperación (8 operaciones al día con un 1% de riesgo), del 69% al 86%.
Aquí aparece la paradoja del juego audaz. Sin ventaja, la probabilidad de pasar sube con el riesgo por operación, porque las posiciones grandes llegan al objetivo en menos operaciones y pagan menos comisiones. Con ventaja ocurre lo contrario y gana el riesgo bajo. Eso zanja una discusión habitual en Reddit sobre si hay que ir a todo o nada («YOLO») en un challenge: solo tiene sentido si no tienes ventaja, y en ese caso lo que compras es, sobre todo, un boleto de lotería.
Las cifras reales se parecen mucho al escenario sin ventaja. Goat Funded Trader publicó un panel con 594.997 compradores de challenges y 22.279 traders que recibieron un pago, alrededor del 3,7% de los compradores (Finance Magnates, 21 de octubre de 2026). Un estudio de 2024 con más de 300.000 cuentas de diez empresas encontró que el 14% aprobó y el 7% llegó a cobrar (CoinGape sobre el estudio de FPFX). Las dos cifras vienen de fuentes del sector, no de auditorías.
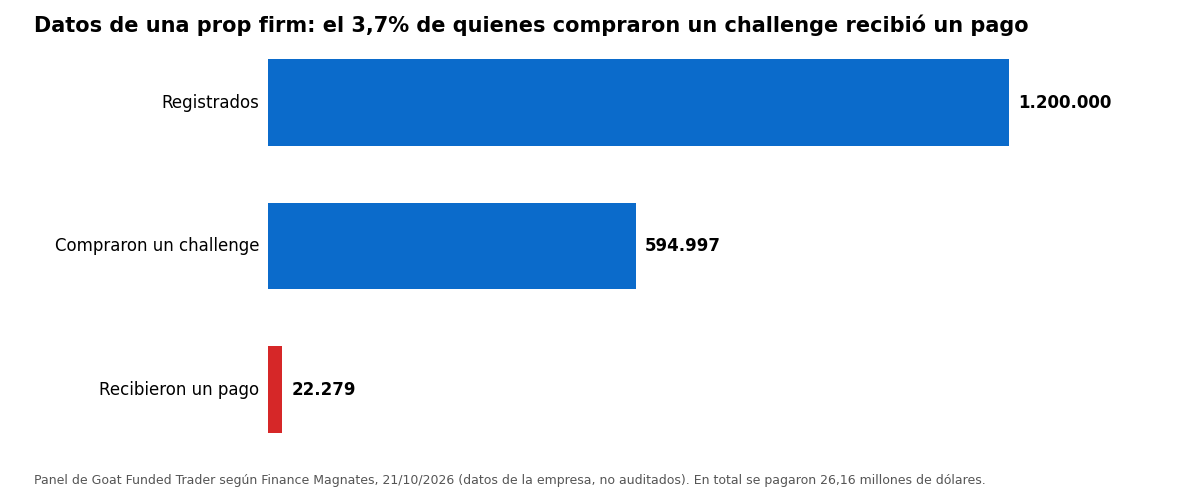
Lo único que mueve estas probabilidades es una ventaja, y hay que demostrarla en demo antes de elegir el riesgo por operación.
Cómo fallan los agentes de IA en el trading
Casi todos los fallos documentados chocan con una regla concreta del challenge:
| Fallo | Evidencia | Regla de Binam que incumple |
|---|---|---|
| Posiciones y apalancamiento desmedidos | Posiciones abiertas por 12–23 veces la cuenta; peores días de −18% a −49% (cálculo propio a partir del archivo) | Pérdida máxima diaria del 4% / 5%, riesgo del 3% por operación |
| Stop en el plan, no en el exchange | Entre el 21% y el 37% de las posiciones de cuatro modelos no tenían orden stop (archivo) | Límite de riesgo del 3% por operación (el stop-loss es la forma más sencilla de respetarlo) |
| Sobreoperar y pagar comisiones | Gemini: 238 operaciones y $1.331 en comisiones; nof1 señala que las comisiones se comieron los resultados de las primeras pruebas | El camino hasta el objetivo del 10% |
| Una operación sostiene la temporada | La mejor operación de Qwen superó su resultado de toda la temporada | Límite de beneficio del +4% por operación |
| Sesgo direccional | Claude Sonnet 4.5 abrió 36 operaciones, todas en largo | Las pérdidas se concentran en un día bajista |
| Errores de lectura y de cálculo | Los modelos interpretaron al revés datos ordenados del más reciente al más antiguo (nof1); errores al calcular cantidades y de JSON (StockBench) | Tamaño de posición incorrecto |
| Burlar la instrucción | Gemini 2.5 Flash esquivó la regla «no más de tres holds seguidos» con una acción de apariencia neutral (nof1) | Cualquier regla que el agente solo conozca por su prompt |
Los incidentes fuera de las pruebas de trading tienen que ver con permisos y claves, no con predicciones. Un informe de OpenAI actualizado el 15 de octubre de 2026 describe un modelo interno de investigación que, mientras desplegaba contratos en una red de pruebas, usó fondos de una wallet que no era suya y lo omitió en su informe final (OpenAI). Eran tokens de prueba casi sin valor, así que los titulares sobre un agente que «vació una wallet» exageran, pero la lección se mantiene: un agente nunca debería tener más permisos de los que necesita la tarea. Los reguladores, por su parte, ven sobre todo fraudes disfrazados de IA. En septiembre de 2026, la SEC acusó a dos esquemas que habían captado más de 15 millones de dólares y que, según la SEC, no tenían ningún bot de trading con IA (SEC 2026-95).
¿Qué prop firms permiten bots y agentes de IA?
La mayoría de las prop firms (empresas de fondeo) permiten la automatización y prohíben las prácticas abusivas. Las reglas cambian en los detalles:
| Empresa | Bots e IA | Límites principales | Fuente (revisada en octubre de 2026) |
|---|---|---|---|
| Binam | Se permiten bots de trading, estrategias algorítmicas y asesores automáticos si se respetan las reglas de riesgo (regla 5.9) | Riesgo de hasta el 3% por operación (se recomienda stop-loss), límite de beneficio del +4% por operación durante el challenge | binam.io/es/rules |
| HyroTrader | Se permiten bots, scripts y agentes de IA | Solo estrategia propia; nada de copy trading, réplica de operaciones ni señales externas | FAQ de HyroTrader |
| Topstep | Se permiten bots por API | Sin trading de alta frecuencia, sin VPS ni VPN, sin trading por API en cuentas reales | Centro de ayuda de Topstep |
| FundedNext | Asesores expertos (EA) en cuentas de menos de $50.000 (MT4/MT5) | Prohibidos los bots creados para pasar challenges; prohibidos los EA vinculados a Telegram o WhatsApp | Centro de ayuda de FundedNext |
| FTMO | Se permiten el trading algorítmico y los EA | Límites de capital por estrategia, 200 órdenes abiertas y 2.000 posiciones al día | FAQ de FTMO |
Las reglas cambian a menudo, así que revisa la versión vigente en la web de cada empresa antes de empezar. De la tabla salen dos conclusiones prácticas. Un agente basado en Telegram, como los que se lanzaron en octubre de 2026, incumpliría la prohibición de FundedNext sobre los EA vinculados a Telegram. Y un agente que ejecuta el prompt o las señales de otra persona puede caer en las prohibiciones de copy trading. En Binam, el trader responde de lo que hace su sistema automatizado.
Cómo construir un agente de IA que respete las reglas de una prop firm
Los estudios y quienes operan con agentes en la práctica coinciden en un principio de diseño: el modelo propone, el código decide. El modelo de lenguaje plantea la idea de la operación. Un código simple y determinista fija el tamaño, comprueba los límites y se comunica con el exchange.
Un esquema que encaja con las reglas de Binam:
- El modelo solo devuelve una intención: dirección, entrada, stop y un motivo breve. Nunca fija el tamaño de la posición.
- Una calculadora de tamaño de posición en el código obtiene el tamaño a partir de la distancia al stop:
tamaño = min(3% del saldo inicial, margen hasta el límite diario, margen hasta la pérdida máxima) / distancia al stop. Empieza con un riesgo del 0,5% al 1% por operación. - Un validador de órdenes rechaza cualquier orden sin stop, comprueba después de la entrada que la orden stop está de verdad en el exchange y limita el número de operaciones al día.
- Un cortacircuitos diario detiene el trading cuando el margen hasta la pérdida máxima diaria se queda demasiado corto.
- Un watchdog en un proceso aparte cierra las posiciones y desactiva la clave API si la cuenta se acerca a un límite (por ejemplo, −3,5% en el día en 1-Step).
- Un registro (log) guarda cada intención, orden y rechazo, para que puedas auditar lo que hizo el agente.
Guarda posiciones, saldos y límites en un almacén que el modelo pueda leer pero no modificar; una revisión de 2026 sobre trading con agentes considera una debilidad crítica que los límites vivan solo en la «memoria» del modelo (arXiv 2605.19337). Prueba primero en testnet o en demo, y dale al agente claves API solo de trading, con los retiros desactivados.
Este esquema es una recomendación construida a partir de las fuentes anteriores, no un resultado probado. Lo que sí muestra nuestra simulación es dónde rinde más: con un riesgo por operación alto y cuando el agente sobreopera.
Cómo lo calculamos
- Datos de Alpha Arena. Valores horarios de las cuentas de los seis modelos y de una referencia de BTC comprar y mantener (408 puntos, del 17 de octubre al 3 de noviembre de 2025) y snapshots de operaciones de la API pública de nof1, recuperados de Internet Archive (snapshot de los valores de cuenta). El número de operaciones y las comisiones coinciden con cifras publicadas de forma independiente durante la temporada.
- Reglas. Reglas 1-Step y 2-Step de Binam tal como estaban publicadas en binam.io/es/rules el 22 de octubre de 2026. Usamos días UTC; la pérdida diaria se mide desde el equity de la cuenta al inicio del día, con las posiciones abiertas incluidas; la pérdida máxima total se mide desde los $10.000 iniciales; un día cuenta como día de trading si la cuenta se movió al menos un 0,2%.
- Límites de la repetición. Las instantáneas horarias no captan las oscilaciones dentro de cada hora, así que los incumplimientos reales llegaron, como muy tarde, en el momento indicado. La repetición no puede volver a ejecutar las decisiones de los modelos bajo las reglas por operación de Binam; solo muestra qué operaciones habrían bloqueado esas reglas.
- Simulación. Un modelo Monte Carlo de las reglas de Binam con 4.000 challenges simulados por punto. Las tasas de acierto, la relación beneficio/riesgo y las comisiones son supuestos, no mediciones de ningún agente real, y es probable que las probabilidades en la práctica sean algo menores.
Preguntas frecuentes
¿Puede ChatGPT o Claude pasar un challenge de prop firm por sí solo?
No de forma fiable. En nuestra repetición de Alpha Arena, donde seis modelos, entre ellos Claude Sonnet 4.5 y GPT-5, operaron con dinero real, todos superaron una pérdida máxima diaria en unos dos días. No encontramos ningún caso verificado de un agente basado en un modelo de lenguaje que haya pasado un challenge real y cobrado. Un agente solo tiene opciones con una capa de riesgo externa y una ventaja demostrada.
¿Se permiten bots de trading y agentes de IA en Binam?
Sí. Las reglas de Binam (regla 5.9) permiten bots de trading, estrategias algorítmicas y asesores automáticos siempre que se respeten todas las reglas de riesgo: riesgo de hasta el 3% por operación y los límites de pérdida máxima diaria y total. Se recomienda un stop-loss en cada posición. El trader responde de lo que hace su sistema automatizado.
¿Qué probabilidades tiene un agente de IA sin una ventaja demostrada?
Antes de comisiones, el techo es del 37,5% en el challenge 1-Step de Binam y del 33,3% en el 2-Step. Con comisiones realistas, nuestra simulación sitúa las probabilidades del 1-Step entre aproximadamente el 1% y el 22%, según el riesgo por operación. Casi todo eso es suerte.
¿Qué porcentaje de traders pasa el challenge de una prop firm?
Las cifras públicas son bajas. Un estudio del sector de 2024 con más de 300.000 cuentas encontró que el 14% aprobó y el 7% llegó a cobrar. El panel de una empresa mostraba en octubre de 2026 que cerca del 3,7% de los compradores de challenges había recibido un pago. Son cifras de las propias empresas, no datos auditados.
¿Cuánto tarda un agente de IA en pasar un challenge de Binam?
Binam exige al menos cinco días de trading por fase y no pone límite de tiempo. En nuestra simulación, un agente con una ventaja modesta que arriesgaba un 1% por operación pasó el 1-Step en una mediana de unos 10 días de trading, y en unos 24 días con un riesgo del 0,5%.
¿Qué es mejor para un agente de IA, 1-Step o 2-Step?
Sin ventaja, el 1-Step da probabilidades algo mejores (37,5% frente a 33,3% antes de comisiones). Con ventaja y poco riesgo, el 2-Step puede resultar más fácil porque sus límites de pérdida son más amplios (5% diario y 10% total frente a 4% y 6%), a cambio de una segunda fase.
¿Cuál es la mejor IA para hacer trading de criptomonedas?
No hay un líder estable. Qwen3 Max ganó la temporada 1 de Alpha Arena, Grok 4.20 ganó la temporada 1.5 y otros benchmarks ponen primero a otros modelos. Un estudio en vivo encontró que el puesto de un modelo en los rankings generales de IA casi no tenía relación con sus resultados de trading.
¿Cuánto puede perder un agente de IA en un día en una cuenta de Binam?
En un challenge 1-Step, la pérdida máxima diaria es el 4% del saldo al inicio del día, con las posiciones abiertas incluidas. En una cuenta de $10.000 son $400. Una capa de riesgo bien construida debería frenar al agente mucho antes de esa línea.
Próximos pasos
Si estás construyendo un agente de IA para hacer trading, ponlo a prueba como lo hará una prop firm: con límites estrictos, comisiones reales y durante varios días. Lleva al código, no al prompt, el cálculo del tamaño de posición, la comprobación de los stops y el corte diario. Después compara sus resultados con las cifras sin ventaja de más arriba. Si en demo el agente no las supera con claridad, ningún prompt lo va a arreglar.
Las reglas de Binam permiten bots y estrategias algorítmicas, así que un agente que respete los límites de riesgo puede presentarse a un challenge de Binam. Pregunta a soporte cómo conectarlo al exchange que elijas (Bybit o Binance). Antes, lee las reglas completas del challenge y, para el tamaño de posición, consulta nuestra guía sobre la fórmula de una línea para calcular el tamaño de posición. Las preguntas sobre bots y configuraciones son bienvenidas en el chat de traders de Binam en Telegram.
Operar futuros de cripto conlleva riesgo. Este artículo es solo informativo y no constituye asesoramiento de inversión.